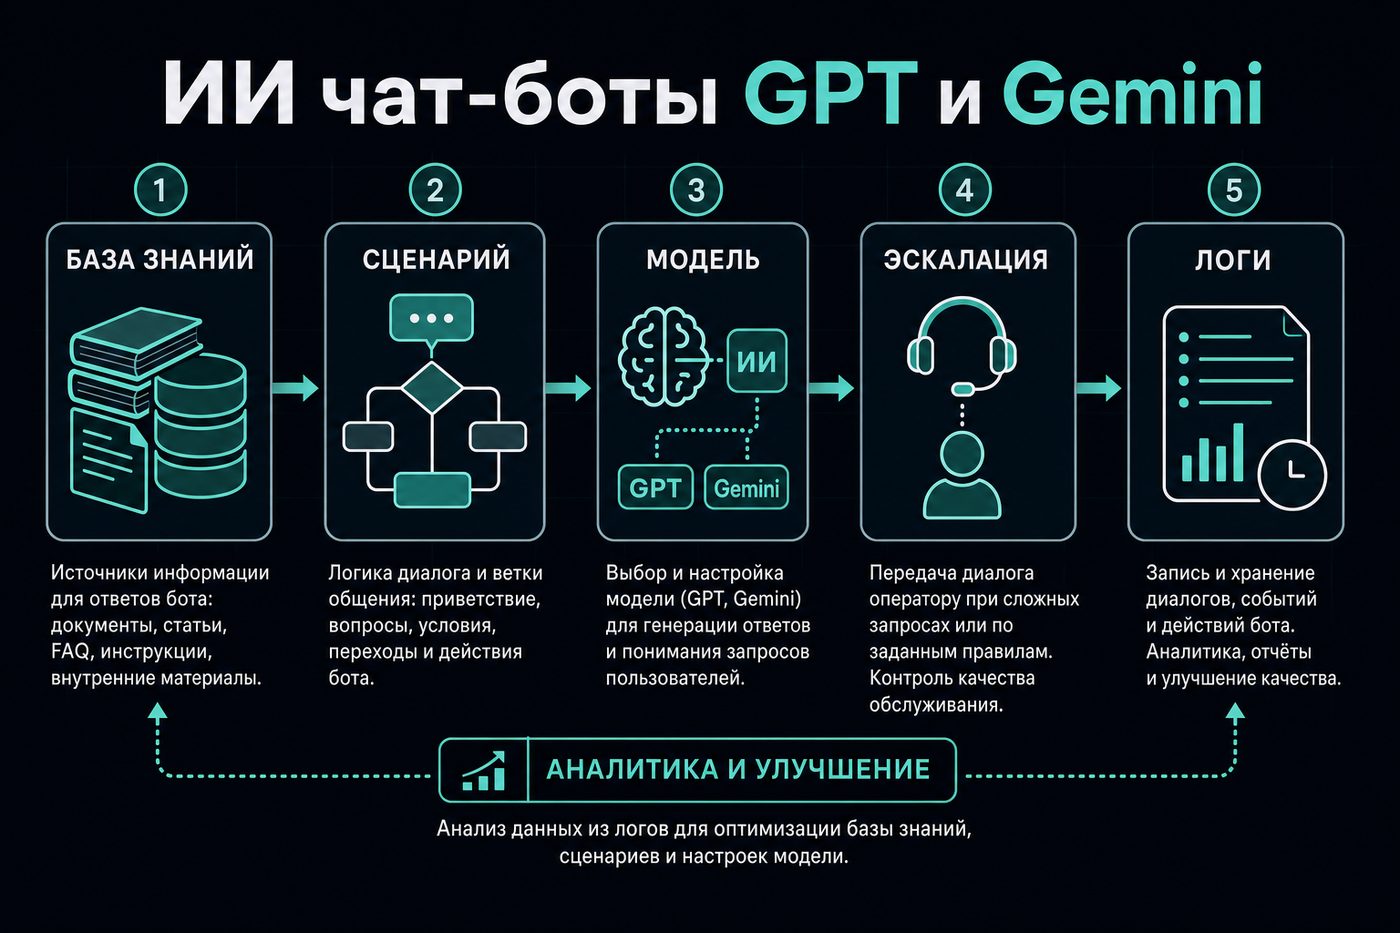
ИИ-чат-боты на базе моделей вроде GPT и Gemini умеют отвечать свободным текстом. Для бизнеса ценность появляется только когда ответы опираются на вашу базу, а сложные кейсы уходят человеку. Сравнивать «какая модель лучше вообще» бессмысленно без ваших FAQ, прайса и типовых возражений.
Ниже — архитектура гибрида, RAG без выдумок, ограничения Telegram Bot API и порядок внедрения, который не превращает бота в генератор случайных обещаний.
Чем ИИ-бот отличается от кнопочного сценария
| Тип | Сильные стороны | Риски |
|---|---|---|
| Сценарий (кнопки/ветви) | предсказуемость, цены, запись | жёсткость, долгая поддержка веток |
| ИИ по базе знаний | гибкие формулировки вопросов | выдумки, если база дырявая |
| Гибрид | FAQ + эскалация + ИИ в узкой зоне | нужно проектировать границы |
На практике чаще выигрывает гибрид: детерминированные шаги для заявки, оплаты и юридических формулировок; ИИ — для пояснений по утверждённым материалам в узкой теме.
Обязательные правила безопасности смысла
- 1. Модель отвечает только по документам, которые вы загрузили и подписали.
- 2. Если уверенности нет — фраза «уточню у специалиста» и эскалация, а не догадка.
- 3. Цены, сроки, гарантии, медицинские и юридические утверждения — вне LLM или в жёстком шаблоне из CRM.
- 4. Логи запросов храните с политикой доступа; не отправляйте ПДн в модель без необходимости.
- 5. Промпт запрещает «придумывать акции» и «обещать скидку без кода».
GPT и Gemini здесь взаимозаменяемы на уровне архитектуры; выбор — по качеству на вашей базе, стоимости токенов, требованиям к данным и доступности API в вашем контуре.
RAG: минимальный рабочий контур
Вопрос пользователя
 → классификатор намерения (FAQ / заявка / спор / off-topic)
 → если FAQ: поиск по базе (chunk + embedding)
 → ответ с цитатой источника (внутренне) + короткий текст пользователю
 → если низкий score — эскалация
 → если заявка — FSM сценария без LLM
База знаний — не «весь сайт как есть», а 30–80 карточек с одним фактом на карточку: «срок монтажа», «что входит в пакет», «как оформить возврат». Карточки обновляет владелец услуги, не разработчик.
Telegram: что не решает модель
- - Бот не пишет первым — ИИ не создаёт аудиторию, только обслуживает входящий диалог.
- - `getUpdates` vs webhook — взаимоисключающие; при падении сервера апдейты не копятся дольше 24 часов.
- - Лимит текста 4096 символов — длинный ответ режьте или давайте ссылку на статью, например бот на Python для технической части.
- - Токен храните в env; ключ LLM — отдельно, с лимитами расхода.
Сравнение GPT и Gemini на практике (без рейтингов «лучше»)
| Критерий | На что смотреть в пилоте |
|---|---|
| Точность на ваших FAQ | 50 реальных вопросов, доля без эскалации |
| Галлюцинации | число ответов с фактами вне базы |
| Стоимость | цена запроса × ожидаемые диалоги в месяц |
| Задержка | p95 времени ответа в Telegram |
| Данные | можно ли не отправлять ПДн, достаточно ли анонимизации |
Пилот на одной модели две недели, затем смена модели на том же наборе вопросов — единственный честный A/B для вашего бизнеса.
Стоимость и лимиты запросов
Считайте не «цену подписки», а стоимость одного закрытого FAQ без эскалации:
(токены in + токены out) × тариф модели × доля успешных FAQЕсли LLM дешевле менеджера только при высокой доле автоматических ответов — сначала улучшайте базу, а не меняйте модель. Дневной cap расхода на ключ API защищает от цикла, когда бот жжёт токены в бесконечном уточнении.
Структура промпта для RAG (скелет)
- 1. Роль: «ты помощник, отвечаешь только по CONTEXT».
- 2. Запрет: не выдумывать цены, сроки, акции.
- 3. Формат: кратко, без гигантских списков в одном сообщении.
- 4. Если CONTEXT пуст — эскалация, без выдуманного ответа.
- 5. Язык: как в вопросе, если политика компании позволяет.
Промпт не заменяет карточки базы — он удерживает модель в рамках.
Мониторинг качества в проде
| Сигнал | Действие |
|---|---|
| Рост эскалаций | дыры в базе, новые FAQ |
| Жалобы «бот соврал» | разбор лога, правка карточки |
| Длинные ответы | лимит токен out |
| 429 от Telegram | очередь, `retry_after` |
Раз в неделю — выборка 20 диалогов глазами редактора.
Гибридный сценарий: пример потока
/start → меню
 «Узнать о услуге» → RAG по базе
 «Оставить заявку» → FSM (услуга, город, телефон)
 «Связаться с человеком» → алерт менеджеру + chat_id
 «Цена» → фиксированный блок из CRM/таблицы, не LLM
Кнопка «Цена» специально не идёт в LLM: модели усредняют и округляют, клиент запоминает неверную цифру.
Интеграция с маркетингом и CRM
- - Payload в `/start` сохраняйте в заявке — см. маркетинговый бот.
- - Эскалация — `sendMessage` в служебный чат с контекстом последних реплик (без лишних ПДн).
- - CRM — вебхук после успешного FSM; LLM не должен «сам» создавать сделку.
Тестирование перед продом
Набор из 50 вопросов из реальной переписки, три прогона:
- 1. Только кнопочный FAQ (baseline).
- 2. RAG без эскалации (увидите галлюцинации).
- 3. RAG + порог score + эскалация (целевой режим).
Метрики: доля ответов без эскалации, доля эскалаций, где человек подтвердил бы ответ, число «опасных» ответов (цена/срок/гарантия вне базы).
Хранение и обновление базы знаний
| Формат | Когда использовать |
|---|---|
| Markdown в git | версии, review через PR |
| Notion / Confluence | нетехническая команда |
| Google Docs | быстрый старт, слабый diff |
| CSV карточек | простой RAG, одна строка = один факт |
Правило: каждое изменение прайса = тикет «обновить карточки N, M» в тот же день. Иначе RAG уверенно отвечает старыми цифрами.
Fallback, если LLM недоступен
Сценарий должен работать без модели:
- - меню и заявка — всегда;
- - FAQ по кнопкам — резерв;
- - сообщение «сейчас отвечаем только по кнопкам, оператор скоро подключится».
API модели падает чаще, чем Telegram. Не блокируйте заявку из-за timeout OpenAI.
Документирование для команды поддержки
Короткая внутренняя памятка (1 страница): какие темы бот закрывает сам, когда звать человека, где править карточки базы, кто перевыпускает токен. Без этого новый менеджер отвечает «из головы», обходя бота и ломая единый источник правды.
Частые ошибки
- - «Подключили ChatGPT к боту» без базы — красивые выдумки.
- - Один промпт «будь вежлив» вместо карточек знаний.
- - Нет порога уверенности — модель всегда отвечает.
- - Заявка тоже через LLM — теряются поля и валидация.
- - Экономия на логах — невозможно понять, где сломалось.
Частые вопросы
Заменит ли ИИ менеджера?
Нет. Он снимает повторяющиеся пояснения по утверждённым материалам. Переговоры, исключения и жалобы — человек.
Можно ли только GPT без Gemini?
Да. Архитектура одна; меняется endpoint и параметры. См. Gemini для маркетинга для внутреннего контура команды.
Нужен ли свой сервер?
Для Telegram-бота — да, процесс, который принимает webhook или polling. LLM может быть облачным API при соблюдении политики данных.
Можно ли fine-tune вместо RAG?
Fine-tune не отменяет обновление фактов при смене прайса: модель «запомнит» старое. Для FAQ практичнее карточки + поиск; fine-tune — редкий кейс с большим архивом однотипных диалогов и редкими правками. На старте почти всегда достаточно RAG.
Гео и язык
- - Региональные FAQ. В базе отдельные карточки «доставка в Казань» и «монтаж в Москве», иначе модель обобщит неверно. Для регионального трафика полезны страницы вроде сайт в Казани с согласованными фактами.
- - Часовые пояса. Эскалация ночью: бот честно пишет время ответа менеджера.
- - Два языка. Два набора карточек лучше, чем «ответь на языке пользователя» без контроля терминов.
Чеклист внедрения
- - [ ] База из утверждённых карточек, владелец обновлений назначен
- - [ ] Гибрид: заявка и цены вне LLM
- - [ ] Порог score и эскалация протестированы
- - [ ] 50 вопросов прогнаны, опасные ответы = 0
- - [ ] Токен бота и ключ LLM в env, лимиты расхода
- - [ ] Webhook/polling стабилен, алерты включены
Что сделать дальше
- 1. Собрать 50 реальных вопросов и карточки FAQ.
- 2. Запустить гибрид на staging.
- 3. Две недели логов → правки базы, не «ещё промпт».
- 4. Подключить один источник трафика.